Reduzindo pela metade o custo de inferência com Flex Processing no Microsoft Foundry e .NET
O Microsoft Foundry é a plataforma da Microsoft para construir e operar aplicações de IA, e entre as opções de processamento dos modelos Azure OpenAI ele agora oferece o Flex Processing, ainda em preview. A proposta é simples: inferência com 50% de desconto em relação ao Standard processing, para workloads que aguentam respostas mais lentas e indisponibilidade ocasional. Neste exemplo, criamos uma aplicação console em .NET 10 que envia o mesmo prompt para o mesmo deployment duas vezes, uma com Flex e outra com Standard, e compara o tier que processou cada request, a latência, o consumo de tokens e o custo estimado.
O ponto que mais chama atenção no Flex é que ele é apenas um parâmetro do request. Não existe um deployment de Flex, um endpoint diferente ou um SDK específico. Basta enviar service_tier com o valor flex em uma chamada da Responses API ou da Chat Completions API, e o mesmo deployment Global Standard passa a processar aquele request no tier mais barato. Para voltar ao Standard, o valor é default.
.NET 10 Console App ──► FoundryClient (HttpClient)
                              │
                              ├─ service_tier = "flex"    ──┐
                              └─ service_tier = "default" ──┤
                                                            ▼
                                     Azure OpenAI Deployment (Global Standard)
                                                            │
                     service_tier + usage + output ◄────────┘
                              │
                              ▼
                 Latência, tokens e custo estimado
O desconto tem um preço, e ele está na latência e na disponibilidade. Requests Flex podem demorar bem mais que os Standard, a latência varia de uma execução para outra, e quando não há capacidade Flex disponível o serviço responde com HTTP 429. O Flex não tem latency SLA nem service SLA. Por outro lado, o modelo é exatamente o mesmo, então a qualidade da resposta não muda. O tier altera latência, disponibilidade e preço, não o output.
Também vale entender onde o Flex se encaixa entre as outras opções. O Standard processing é o processamento online best effort, cobrado pela tarifa normal por token. O Priority processing vai no sentido oposto do Flex, cobrando mais para entregar uma latência menor e mais consistente. O Batch trabalha com jobs assíncronos que têm até 24 horas para terminar, e o Provisioned Throughput reserva capacidade com throughput previsível. Uma diferença importante entre Flex e Batch é que a chamada Flex continua síncrona: a conexão fica aberta até a resposta chegar, mesmo que isso leve minutos.
Na prática, o Flex faz sentido para trabalho que pode esperar, como avaliações de modelo, data enrichment, análise de documentos, jobs em background e workflows assíncronos. Ele não é uma boa escolha quando existe um usuário esperando a resposta, quando há uma meta de latência rígida, quando a aplicação não consegue tratar um HTTP 429 ou quando o workload precisa de capacidade reservada.
Três detalhes de arquitetura vão aparecer várias vezes no código. O primeiro é que Flex e Standard usam a mesma quota do deployment Global Standard, então um request Flex consome o mesmo rate limit do Standard. O segundo é que não existe fallback automático: se o Flex não tiver capacidade, o serviço não reenvia o request como Standard, essa decisão é sempre da aplicação. O terceiro é que o tier que realmente processou o request volta no campo service_tier da resposta, e é esse valor que define a cobrança.
Antes de criar qualquer recurso, é preciso escolher um modelo que suporte Flex. No momento em que escrevemos este artigo, a tabela de modelos suportados lista o gpt-5.6-sol, o gpt-5.6-luna e o gpt-5.6-terra na versão 2026-07-09, e o gpt-6-astra na versão 2026-09-03, todos com o deployment type Global Standard. A versão do modelo importa, e um modelo ou versão que não está na tabela retorna HTTP 400 invalid_request_error, sem cair para o Standard. Por isso, a tabela oficial deve ser sempre a referência, e não a suposição de que um modelo suporta Flex só porque suporta Standard ou Priority.
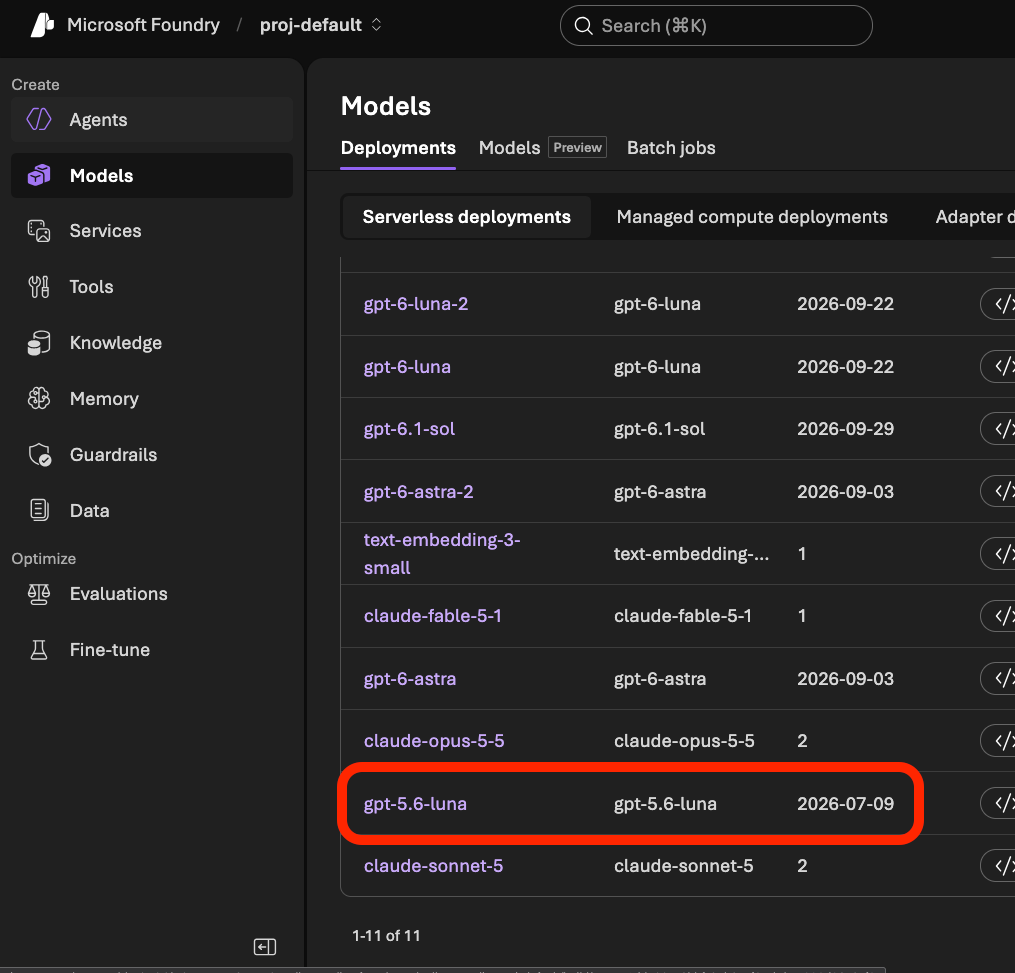
No nosso exemplo usamos o GPT-5.6 Luna. No Foundry, abrimos o model catalog, selecionamos o gpt-5.6-luna na versão 2026-07-09 e fizemos o deploy com o deployment type Global Standard, com o nome flex-demo. Esse nome é o valor que a aplicação vai enviar no campo model de cada request.
Quem preferir a linha de comando pode criar o mesmo deployment com o Azure CLI. O comando abaixo cria o deployment Global Standard em um recurso Azure OpenAI já existente:
az cognitiveservices account deployment create \
  --name <RESOURCE_NAME> \
  --resource-group <RESOURCE_GROUP> \
  --deployment-name flex-demo \
  --model-name gpt-5.6-luna \
  --model-version 2026-07-09 \
  --model-format OpenAI \
  --sku-name GlobalStandard \
  --sku-capacity 10
Com o deployment pronto, copiamos o endpoint e uma das API keys do recurso, em Keys and Endpoint. A aplicação lê toda a configuração de environment variables, e o repositório traz um arquivo .env.example com a lista completa. Basta copiar para .env na raiz do repositório e preencher os valores:
# Required
AZURE_OPENAI_ENDPOINT=https://<RESOURCE_NAME>.openai.azure.com
AZURE_OPENAI_API_KEY=<YOUR_API_KEY>
AZURE_OPENAI_DEPLOYMENT=<YOUR_DEPLOYMENT_NAME>

# Optional: Standard fallback after a Flex HTTP 429 (default: false)
FLEX_FALLBACK_ENABLED=false

# Optional: client timeout in seconds (default: 900 = 15 minutes)
REQUEST_TIMEOUT_SECONDS=900

# Optional: prices in USD per 1M tokens (Global Standard, short context up to 272K input tokens).
STANDARD_INPUT_PRICE_PER_MILLION=0.20
STANDARD_CACHED_INPUT_PRICE_PER_MILLION=0.02
STANDARD_OUTPUT_PRICE_PER_MILLION=1.20

# Flex: 50% of the Standard rates.
FLEX_INPUT_PRICE_PER_MILLION=0.10
FLEX_CACHED_INPUT_PRICE_PER_MILLION=0.01
FLEX_OUTPUT_PRICE_PER_MILLION=0.60
As três primeiras variáveis são obrigatórias. O REQUEST_TIMEOUT_SECONDS tem 900 segundos como padrão porque a própria documentação do Flex sugere começar com um timeout de 15 minutos, já que um request Flex pode demorar bem mais que um Standard. Os preços são do GPT-5.6 Luna em Global Standard, e os valores Flex são exatamente metade dos Standard. Esses números mudam, então antes de usar a estimativa vale conferir as tarifas atuais na página de preços do Azure OpenAI e ajustar as variáveis se o modelo ou o contrato forem outros.
Ao iniciar, a aplicação carrega o .env da pasta atual, e uma variável que já existe no shell tem precedência sobre o arquivo. Depois disso, a classe DemoSettings valida tudo de uma vez: verifica se as variáveis obrigatórias existem, se ainda contêm um placeholder como <YOUR_API_KEY>, se o endpoint é uma URL https e se os preços, o timeout e o fallback têm valores válidos. Um endpoint copiado com o caminho /openai/v1/ no final também é aceito, porque o sufixo é removido. Se algo estiver errado, a aplicação lista todos os problemas e encerra, em vez de falhar na primeira chamada à API.
Passando para o código, o projeto FlexProcessingDemo é um console em .NET 10 sem nenhuma dependência NuGet. As chamadas usam o HttpClient e o System.Text.Json diretamente, justamente para deixar visível cada campo enviado e recebido da Responses API. Cada request produz um ProcessingResult:
public sealed record ProcessingResult(
    string RequestedTier,
    string ActualTier,
    string Text,
    int InputTokens,
    int OutputTokens,
    int CachedInputTokens,
    TimeSpan Duration
);
O detalhe aqui é a separação entre RequestedTier e ActualTier. O primeiro é o tier que pedimos no request, e o segundo é o que a API reportou no campo service_tier da resposta. Os dois ficam separados de propósito, porque a aplicação nunca assume que o tier pedido é o tier que processou o request. InputTokens já inclui os tokens que vieram do cache, CachedInputTokens é esse subconjunto, e OutputTokens inclui os reasoning tokens.
Quem faz a chamada à API é o FoundryClient. O método principal monta o body, envia o request e mede o tempo:
public async Task<ProcessingResult> ExecuteAsync(
    string input,
    string serviceTier,
    CancellationToken cancellationToken = default)
{
    var body = new
    {
        model = _deployment,
        input,
        service_tier = serviceTier
    };

    using var request = new HttpRequestMessage(
        HttpMethod.Post,
        $"{_endpoint}/openai/v1/responses")
    {
        Content = JsonContent.Create(body)
    };
    request.Headers.Add("api-key", _apiKey);

    var stopwatch = Stopwatch.StartNew();
    string responseBody;
    HttpResponseMessage response;

    try
    {
        response = await _http.SendAsync(request, cancellationToken);
        responseBody = await response.Content.ReadAsStringAsync(cancellationToken);
    }
    catch (TaskCanceledException ex) when (!cancellationToken.IsCancellationRequested)
    {
        throw new TimeoutException(
            $"The request did not complete within {_http.Timeout.TotalSeconds:F0} seconds.", ex);
    }

    stopwatch.Stop();

    using (response)
    {
        if (!response.IsSuccessStatusCode)
        {
            throw FoundryRequestException.FromResponse(response, responseBody);
        }
    }

    return ParseResponse(responseBody, serviceTier, stopwatch.Elapsed);
}
ExecuteAsync()
- Envia um
POSTpara{endpoint}/openai/v1/responsescom o nome do deployment no campomodel, o prompt eminpute o tier emservice_tier. A autenticação usa o headerapi-key. A única coisa que muda entre Flex e Standard é o valor deservice_tier: endpoint, deployment, chave e prompt são os mesmos. - A latência é medida com
Stopwatchem volta da chamada HTTP inteira, incluindo a leitura do body, então é o tempo real percebido pelo cliente. - Quando o timeout do
HttpClientexpira, o .NET lança umaTaskCanceledException. O método a converte emTimeoutExceptionquando o CancellationToken não foi cancelado, assim um timeout não se confunde com o Ctrl+C do usuário. - Qualquer status que não seja sucesso vira uma
FoundryRequestException, que vamos ver mais adiante.
O body enviado é o mesmo que a documentação mostra em REST. Em curl, um request Flex fica assim:
curl -X POST "$AZURE_OPENAI_ENDPOINT/openai/v1/responses" \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -d '{
    "model": "flex-demo",
    "input": "You are a senior cloud architect writing for a team of software engineers. ...",
    "service_tier": "flex"
  }'
A resposta traz o texto gerado, o tier que processou o request e o consumo de tokens. O ParseResponse começa lendo o tier:
var actualTier =
    root.TryGetProperty("service_tier", out var tier) &&
    tier.ValueKind == JsonValueKind.String
        ? tier.GetString()!
        : "unknown";
Se o campo não vier ou vier null, o tier fica como unknown, e o custo desse resultado não é estimado. Em seguida, o método lê usage.input_tokens, usage.output_tokens e usage.input_tokens_details.cached_tokens, e por fim junta o texto gerado:
foreach (var output in outputItems.EnumerateArray())
{
    if (!output.TryGetProperty("content", out var content) ||
        content.ValueKind != JsonValueKind.Array)
        continue;

    foreach (var item in content.EnumerateArray())
    {
        if (item.TryGetProperty("type", out var type) &&
            type.GetString() == "output_text" &&
            item.TryGetProperty("text", out var text))
        {
            textParts.Add(text.GetString() ?? "");
        }
    }
}
O array output da Responses API mistura itens de reasoning e itens de mensagem. Os itens de reasoning não têm content, então são ignorados, e só os blocos output_text das mensagens entram no texto final.
O prompt fica no arquivo prompt.txt, que o build copia para a pasta de saída, e é o mesmo em todos os requests para que as execuções Flex e Standard sejam comparáveis. Ele pede para o modelo, no papel de um arquiteto de cloud, ler um documento técnico de cerca de 2.300 palavras sobre aplicações de IA cloud native no Azure e produzir um relatório em Markdown com sete seções, entre 2.000 e 2.500 palavras. O tamanho é proposital. São cerca de 3.000 tokens de input e alguns milhares de tokens de output, e como o output domina o tempo de geração e o custo, a diferença entre os tiers fica fácil de enxergar. Um prompt pequeno deixaria tudo próximo de zero.
Com o código entendido, podemos rodar a aplicação. Os comandos abaixo restauram, compilam e iniciam o console a partir da raiz do repositório:
dotnet restore
dotnet build
dotnet run --project src/FlexProcessingDemo
A aplicação abre um menu com as quatro demonstrações:
========================================
 Microsoft Foundry Flex Processing Demo
========================================

Model:    flex-demo
Endpoint: https://<RESOURCE_NAME>.openai.azure.com
Fallback: disabled

1. Run with Flex
2. Run with Standard
3. Compare Flex vs Standard
4. Run Flex with Standard fallback
0. Exit

Select an option:
As opções 1 e 2 chamam o mesmo ExecuteAsync, uma com flex e outra com default, e imprimem a resposta seguida das métricas do ProcessingResult. Também é possível rodar uma opção sem o menu, passando o número como argumento, por exemplo dotnet run --project src/FlexProcessingDemo -- 3, e o processo termina com exit code 0 em caso de sucesso e 1 em caso de falha. Durante um request, o Ctrl+C cancela a chamada em andamento e volta para o menu.
Executando a opção 1, depois de alguns segundos a aplicação mostra o relatório gerado e as métricas. O campo Actual tier confirma que o request foi realmente processado pelo Flex.
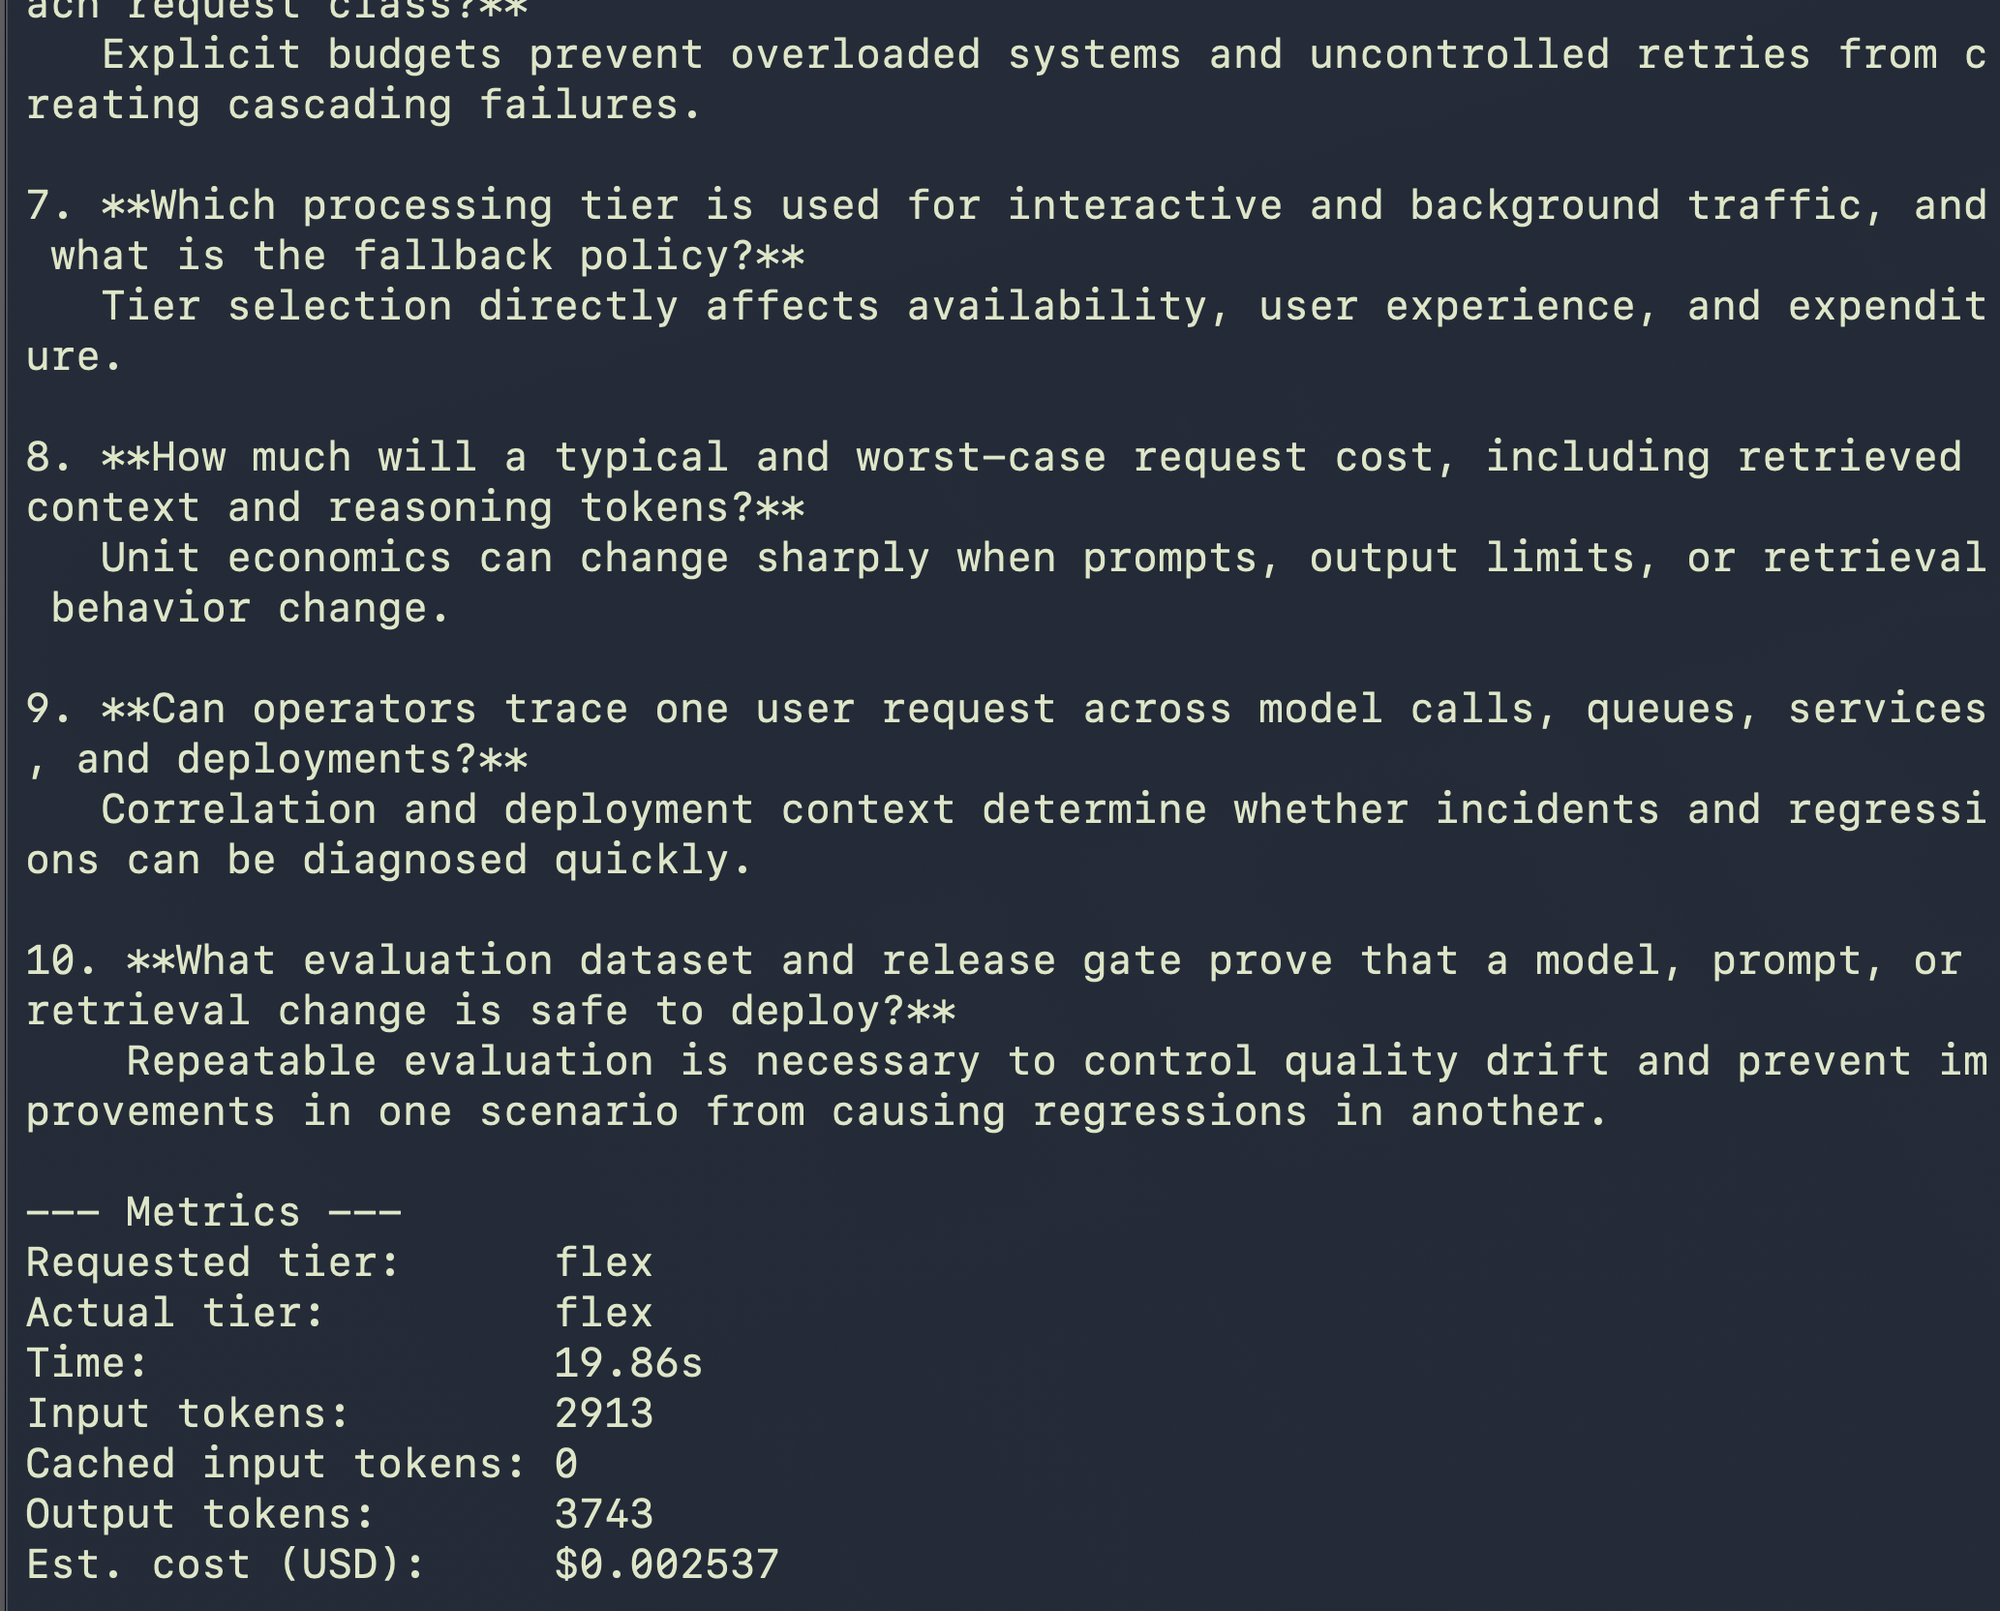
O custo exibido nas métricas vem do CostCalculator. Ele tem duas fórmulas, uma simples, que ignora o cache, e outra que considera os cached tokens, que é a usada pela aplicação:
public static decimal Calculate(
    int inputTokens,
    int cachedInputTokens,
    int outputTokens,
    TokenPrices prices)
{
    if (cachedInputTokens < 0 || cachedInputTokens > inputTokens)
        throw new ArgumentOutOfRangeException(
            nameof(cachedInputTokens),
            "Cached input tokens must be between 0 and the total input tokens.");

    var uncachedInputTokens = inputTokens - cachedInputTokens;

    return
        (uncachedInputTokens / 1_000_000m * prices.InputPerMillion) +
        (cachedInputTokens / 1_000_000m * prices.CachedInputPerMillion) +
        (outputTokens / 1_000_000m * prices.OutputPerMillion);
}
CostCalculator.Calculate()
- Como
usage.input_tokensjá inclui os tokens que vieram do cache, só a parte não cacheada é cobrada pela tarifa cheia de input, e os cached tokens são cobrados pela tarifa de cached input. Somar o custo dos cached tokens por cima do input total contaria esses tokens duas vezes. Os reasoning tokens já estão emoutput_tokense são cobrados como output.
Outro cuidado é qual tabela de preços usar. O resultado é sempre precificado pelo tier que a API reportou, e não pelo tier pedido:
string FormatEstimatedCost(ProcessingResult result) =>
    result.ActualTier switch
    {
        "flex" => FormatUsd(CostCalculator.Calculate(result, settings.FlexPrices)),
        "default" => FormatUsd(CostCalculator.Calculate(result, settings.StandardPrices)),
        _ => $"n/a (tier '{result.ActualTier}')"
    };
Se a API reportar um tier diferente do pedido, a aplicação também imprime um aviso, porque o service_tier da resposta é o que vale para a cobrança.
Essa estimativa tem uma limitação que vale deixar clara. Na família GPT-5.6 e posteriores, o Prompt Caching passou a reportar as escritas de cache no campo cache_write_tokens, e essas escritas podem ser cobradas além das leituras com desconto. O CostCalculator considera apenas as leituras, em cached_tokens, então o valor exibido é uma estimativa para comparar os tiers, não um dado de billing.
A opção 3 é a mais interessante, porque coloca os dois tiers lado a lado. Ela envia o prompt com Flex, depois com Standard, imprime as duas respostas e monta uma tabela com os valores reais retornados pela API e medidos pelo Stopwatch. Só que as duas execuções quase sempre geram quantidades diferentes de output, então comparar o custo de uma com o custo da outra mistura o efeito do tier com o efeito do tamanho da resposta. Para isolar o tier, a aplicação também precifica o mesmo consumo, o da amostra Standard, nas duas tabelas:
var standardCost = CostCalculator.Calculate(standard, settings.StandardPrices);
var flexCost = CostCalculator.Calculate(standard, settings.FlexPrices);
var savings = standardCost - flexCost;
Com os preços padrão, cada tarifa Flex é exatamente metade da Standard, então esse bloco sempre mostra 50% de economia. A tabela de cima é a que mostra a diferença de latência.
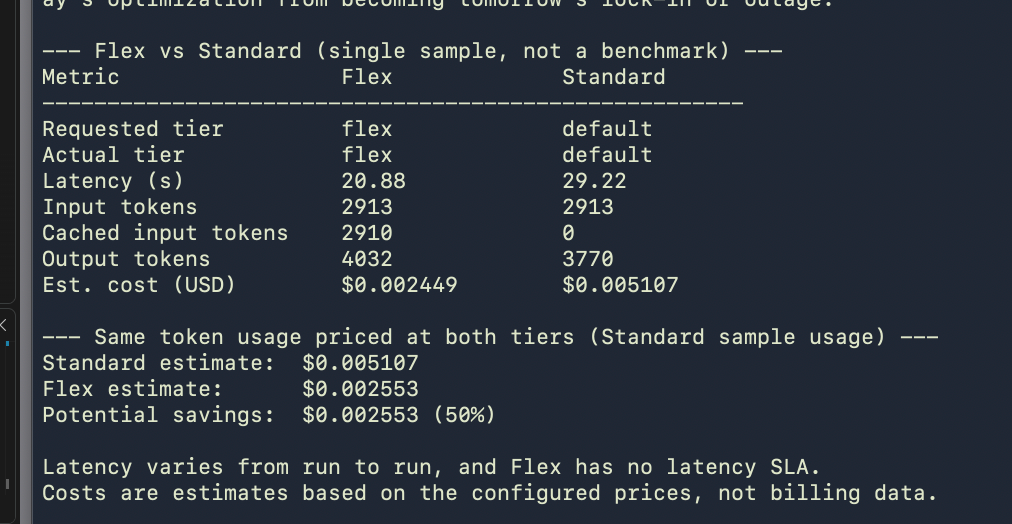
Alguns cuidados na leitura desse resultado. Uma execução é uma amostra, não um benchmark: o Flex costuma ser mais lento, mas não em todo request, então o ideal é rodar a comparação algumas vezes e em horários diferentes. Os tokens de input normalmente são iguais nos dois tiers, porque o prompt é o mesmo, e os de output variam porque a geração varia. Além disso, como a opção 3 envia o mesmo prompt longo duas vezes seguidas, o request Standard pode reaproveitar o prefixo processado pelo Flex e vir com cached tokens, o que reduz o custo de input e pode encurtar um pouco a latência. Para diminuir esse efeito, podemos rodar as opções 1 e 2 separadamente, com alguns minutos de intervalo. Se um dos dois requests falhar, a aplicação mostra o erro e o resultado que deu certo, sem inventar o lado que faltou.
Até aqui tudo funcionou, mas o Flex exige atenção especial ao tratamento de erros. Qualquer resposta que não seja sucesso vira uma FoundryRequestException, que guarda o status HTTP, os campos error.type, error.code e error.message do body e o atraso sugerido pelo serviço nos headers Retry-After ou retry-after-ms. A partir do status, o DescribeError do Program.cs mostra uma orientação para cada caso, seguindo a tabela de erros da documentação:
var hint = (int?)api.StatusCode switch
{
    400 => "The request was rejected and was NOT processed by Flex. The service does not fall back\n" +
           "to Standard. Check that the model and version support Flex (see the supported-model\n" +
           "table in the Flex docs). Don't resend the same request unchanged.",
    401 or 403 => "Authentication failed. Check AZURE_OPENAI_API_KEY and AZURE_OPENAI_ENDPOINT.\n" +
                  "Retrying won't help until the configuration changes.",
    404 => "Deployment not found. Check that AZURE_OPENAI_DEPLOYMENT matches the deployment name\n" +
           "and that AZURE_OPENAI_ENDPOINT points to the right resource.",
    408 => "The service timed out. Retry with backoff, or use Standard if completion time matters.",
    429 => "Flex capacity is unavailable OR the deployment quota/rate limit was exceeded.\n" +
           "Flex and Standard share the same deployment quota." +
           (api.RetryAfter is { } wait ? $"\nThe service suggested retrying after {wait.TotalSeconds:F0}s." : ""),
    >= 500 => "Transient service error. Retry later with bounded exponential backoff.",
    _ => null
};
A regra mais importante é separar falhas permanentes de falhas transitórias. Um 400 significa que o modelo, a versão, o tamanho de contexto ou a configuração do request não suportam Flex, e repetir o mesmo request não vai funcionar. O mesmo vale para 401, 403 e 404, que dependem de corrigir credencial, endpoint ou nome do deployment. Já 408, 429 e 5xx são transitórios e podem ser repetidos com backoff. O 429 merece atenção extra porque é ambíguo: ele pode indicar que não há capacidade Flex disponível ou que a quota do deployment foi atingida, e como a quota é compartilhada, um 429 de quota também bloqueia o Standard. Os limites de quota e rate limit estão descritos em quotas e limites do Azure OpenAI.
É exatamente por causa do 429 que a opção 4 existe. Como o serviço nunca faz fallback sozinho, implementamos um fallback explícito, no padrão que a documentação chama de completion first:
public async Task<ProcessingResult> ExecuteFlexWithFallbackAsync(
    string input,
    bool enableFallback,
    Action<FoundryRequestException>? onFallback = null,
    CancellationToken cancellationToken = default)
{
    try
    {
        return await ExecuteAsync(input, "flex", cancellationToken);
    }
    catch (FoundryRequestException ex)
        when (enableFallback && ex.StatusCode == HttpStatusCode.TooManyRequests)
    {
        onFallback?.Invoke(ex);

        return await ExecuteAsync(input, "default", cancellationToken);
    }
}
ExecuteFlexWithFallbackAsync()
- Tenta o Flex primeiro. Se o Flex responder HTTP 429 e o fallback estiver habilitado, o mesmo prompt é enviado uma única vez com
service_tierigual adefault. O callbackonFallbackpermite que oProgram.csavise o usuário, mostrando a mensagem do serviço e oRetry-After, antes da segunda chamada. - O filtro
whengarante que só o 429 aciona o fallback. Um 400 continua sendo reportado como erro, para que um modelo sem suporte a Flex não passe despercebido virando Standard em silêncio.
O fallback vem desligado por padrão porque ele muda a cobrança: o request que cai para o Standard é cobrado pela tarifa Standard. Para testar, habilitamos a variável e executamos a opção 4:
export FLEX_FALLBACK_ENABLED="true"
dotnet run --project src/FlexProcessingDemo -- 4
Na maioria das vezes o Flex aceita o request e a opção 4 se comporta igual à opção 1, porque o fallback só roda quando o serviço realmente devolve 429. Quando isso acontece e o Standard também responde 429, a aplicação explica que a quota é compartilhada e que é preciso esperar ou aumentar a quota do deployment. Um detalhe a favor do Flex é que um request rejeitado por falta de capacidade não é cobrado, embora ainda consuma o rate limit compartilhado.
Para manter o exemplo pequeno, o fallback acontece logo após o primeiro 429. Em um workload que prioriza o menor custo, a documentação recomenda primeiro repetir o Flex com exponential backoff e jitter, respeitando o Retry-After e com um número limitado de tentativas, e só depois cair para o Standard ou retornar uma falha explícita. A propriedade RetryAfter da FoundryRequestException já entrega o valor necessário para montar esse loop.
Fora da aplicação, o Azure Monitor permite acompanhar o tráfego Flex separado do Standard no mesmo deployment. No recurso, em Metrics, adicionamos a métrica Azure OpenAI Requests com um filtro em ServiceTierRequest igual a flex. A mesma ideia vale para latência, uso de tokens e erros, e o guia de monitoramento do Azure OpenAI detalha as métricas disponíveis.
Para o custo real, e não a estimativa da aplicação, o caminho é o Cost analysis do Microsoft Cost Management. O uso Flex é cobrado em meters dedicados, então basta agrupar ou filtrar por Meter para separar Flex de Standard, e usar a tag deployment para chegar no deployment específico.
Para levar esse padrão a produção, alguns pontos ficam de fora do exemplo de propósito. A autenticação por API key em environment variables é conveniente para uma demo, mas o recomendado é usar Microsoft Entra ID, sem chave, ou ao menos guardar a chave no Azure Key Vault e rotacioná-la. Também vale registrar o service_tier retornado junto com latência, tokens e custo, separar o tráfego interativo do tráfego em background e testar os caminhos de erro antes de colocar o Flex em um workflow real. Por fim, quando existe um gateway ou proxy na frente da aplicação, o header x-ms-service-tier permite escolher o tier sem alterar o body, e ele tem precedência sobre o service_tier do request.
O resumo é que o Flex Processing corta pela metade o custo por token com uma única mudança no request, desde que o workload aceite latência variável e trate o 429. O mesmo deployment atende os dois tiers, o service_tier da resposta diz quem processou e quanto custou, e o fallback para o Standard é uma decisão consciente da aplicação, nunca um comportamento implícito.
Você já pode baixar o projeto por esse link, e não esquece de me seguir no LinkedIn!
Até a próxima, abraços!