Memória de longo prazo para agentes de IA: um vault no Obsidian a serviço do GitHub Copilot - Parte 3
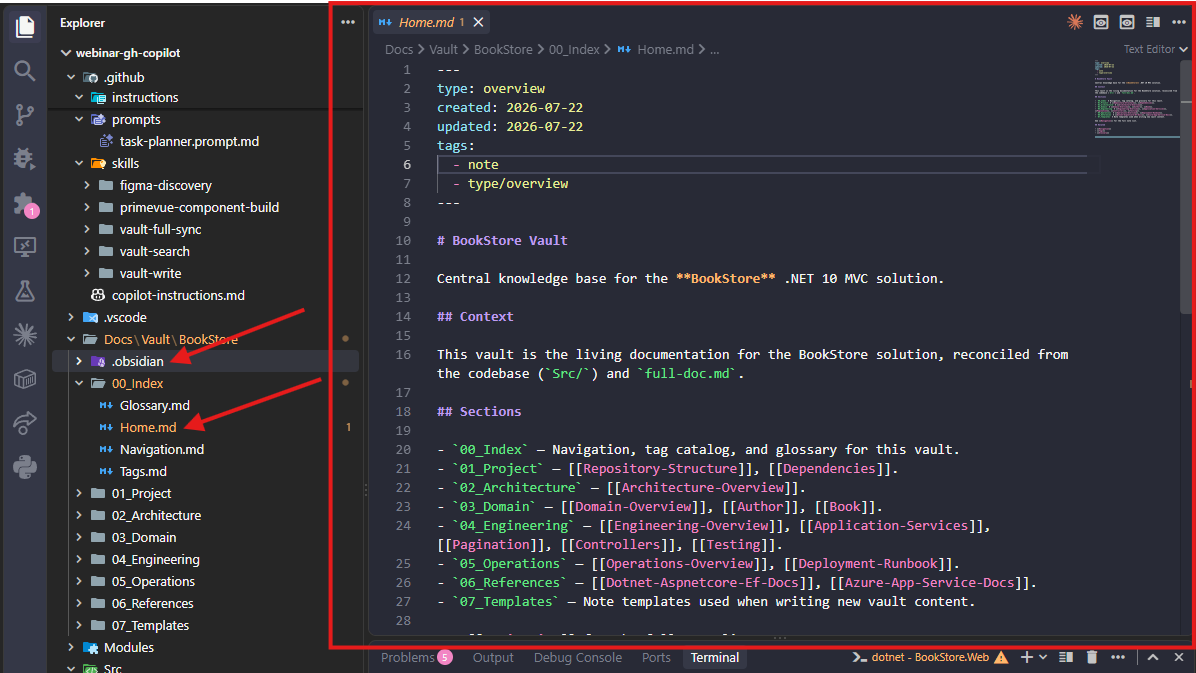
Um dos limites conhecidos de qualquer sessão de chat com uma IA é que ela termina, e o contexto acumulado durante o trabalho some junto. O GitHub Copilot resolve isso em parte com Custom Agents, mas um agente sozinho não guarda memória entre uma conversa e outra, a menos que exista um lugar concreto para escrever o que foi aprendido. No projeto BookStore, esse lugar é um vault de documentação em Obsidian, guardado dentro do próprio repositório em BookStore, e mantido através de duas skills dedicadas: /vault-search e /vault-write. Esta é a Parte 3 da série sobre a modernização do front-end do BookStore, e o assunto agora é como esse vault, combinado a um conjunto de composables Vue reutilizáveis, funciona como a memória de longo prazo dos agentes Frontend-Tooling-Specialist e Frontend-Specialist.
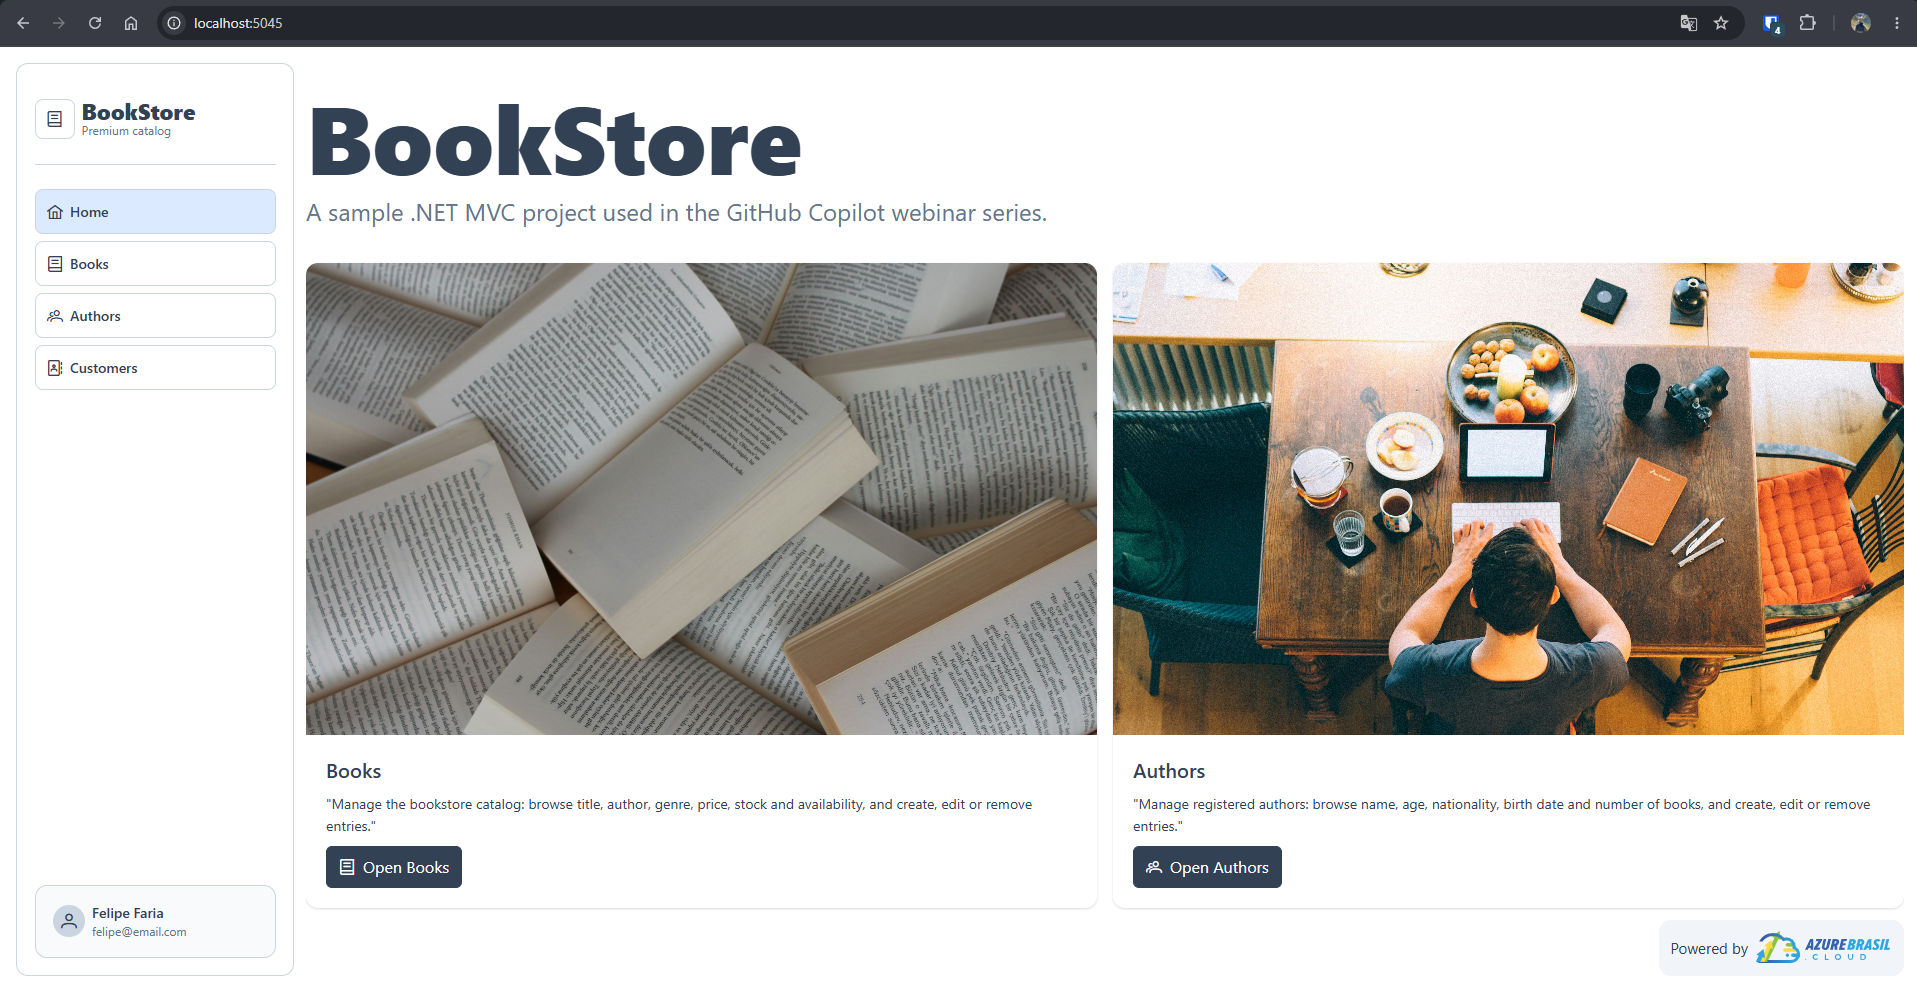
Tela Home:
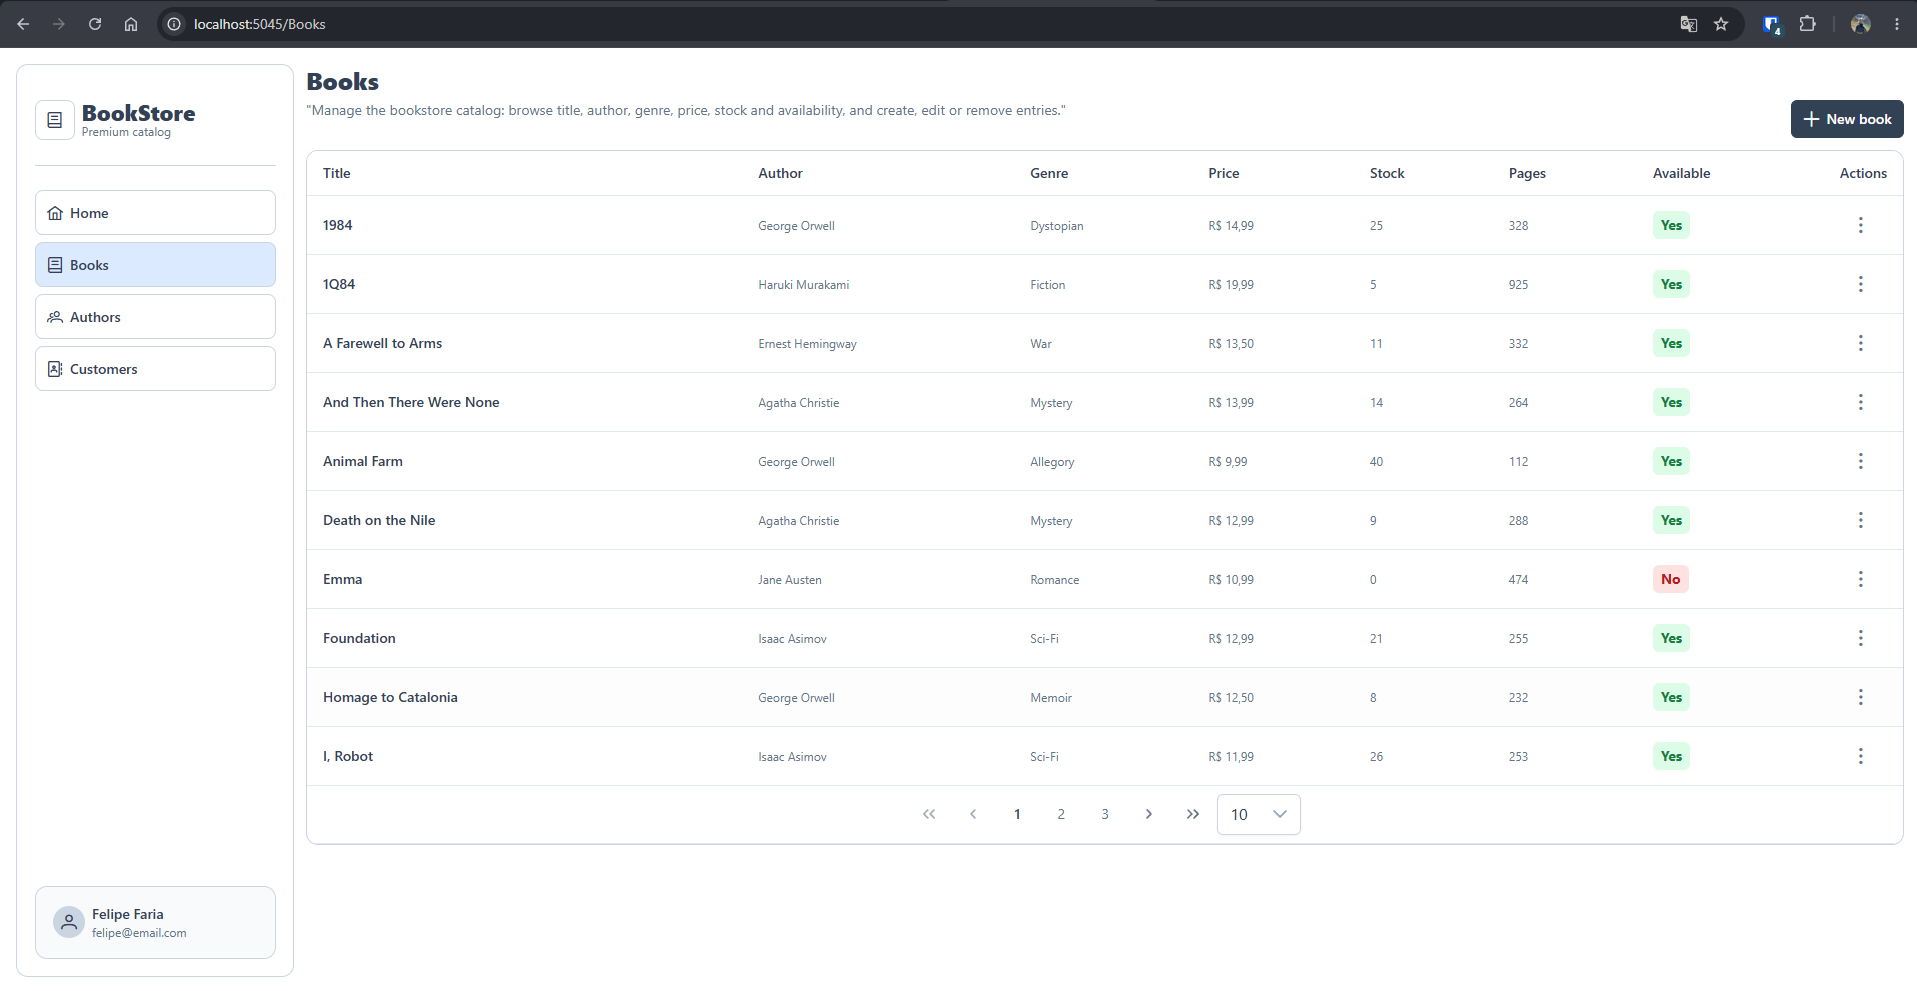
Tela Books:
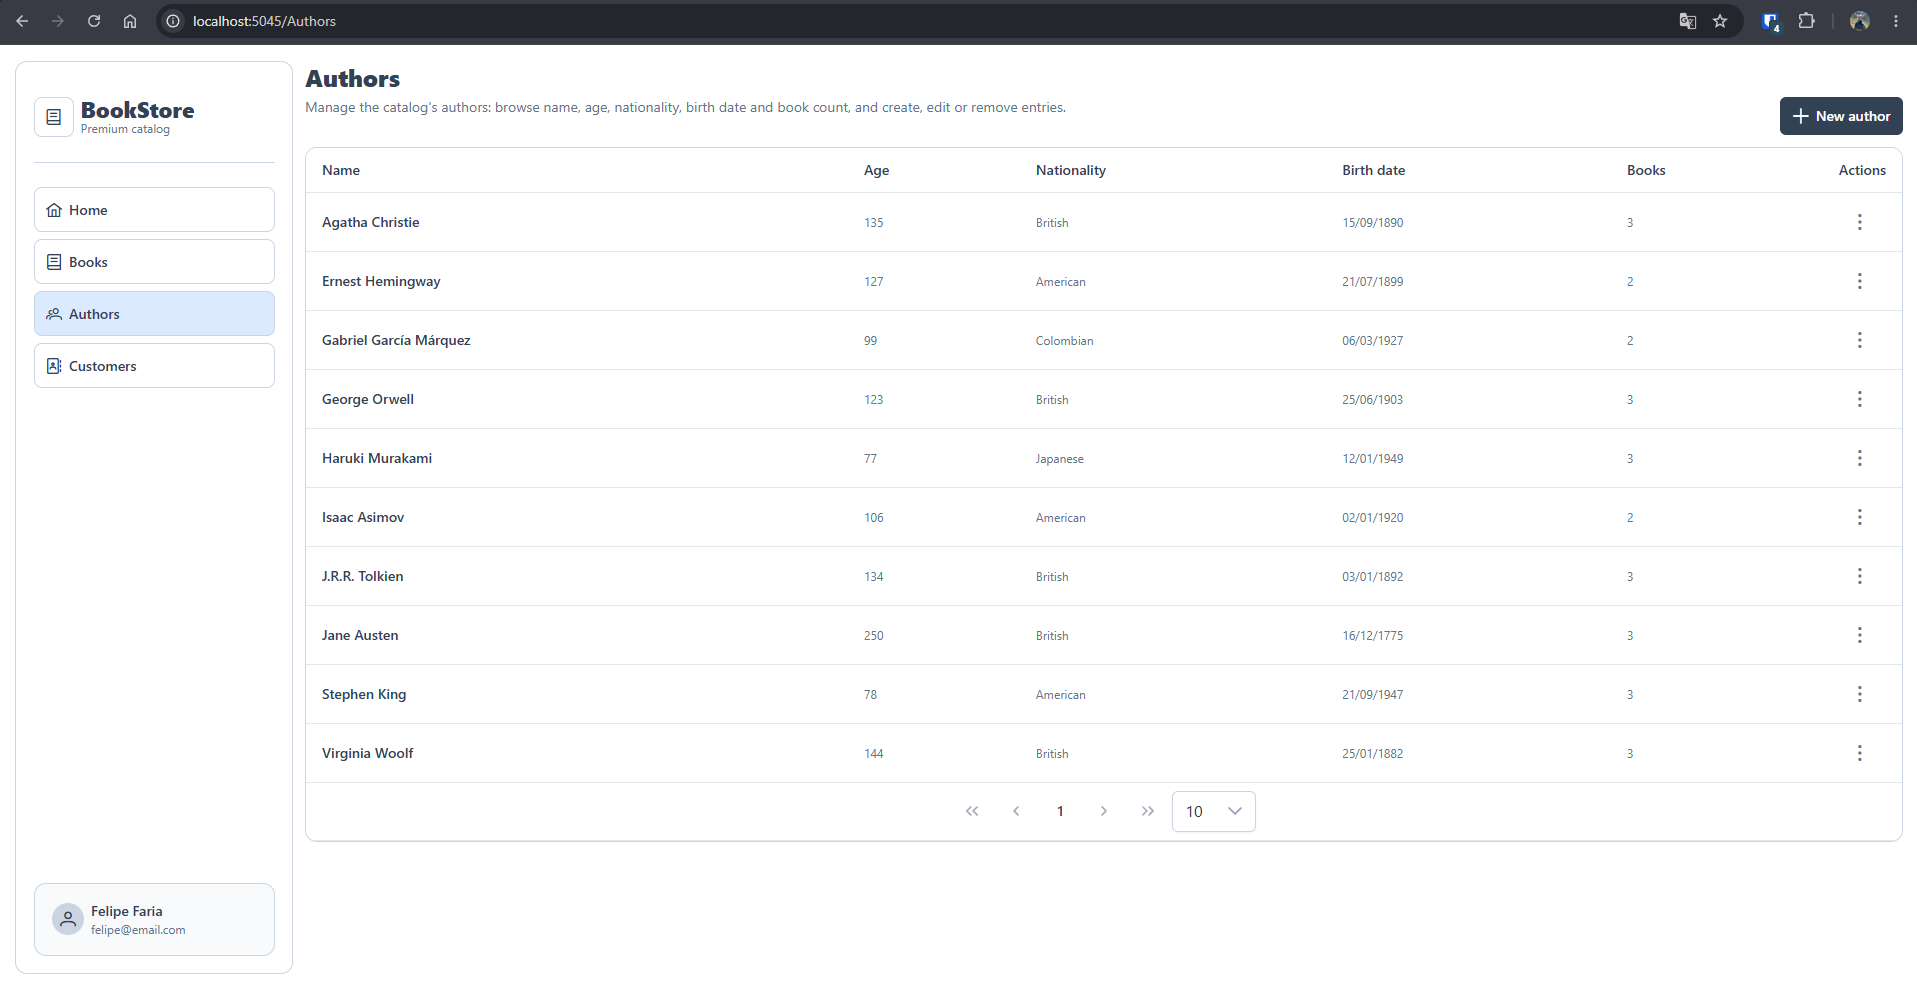
Tela Authors:
O problema que essa combinação resolve é bem concreto. Numa sessão anterior, o GitHub Copilot pode ter descoberto que o Tailwind CSS v4 não enxerga classes usadas apenas em arquivos .cshtml fora da pasta do Vite, e ter corrigido isso com uma diretiva @source. Se essa descoberta não for registrada em algum lugar, o próximo agente, numa sessão diferente, corre o risco de gastar tempo redescobrindo o mesmo problema, ou pior, de reintroduzir o bug sem perceber. O vault existe justamente para que esse tipo de conhecimento vire documentação viva, e não conhecimento tribal perdido no histórico de um chat.
As regras desse vault estão centralizadas num arquivo de instruções que qualquer agente deve carregar antes de tocar em documentação:
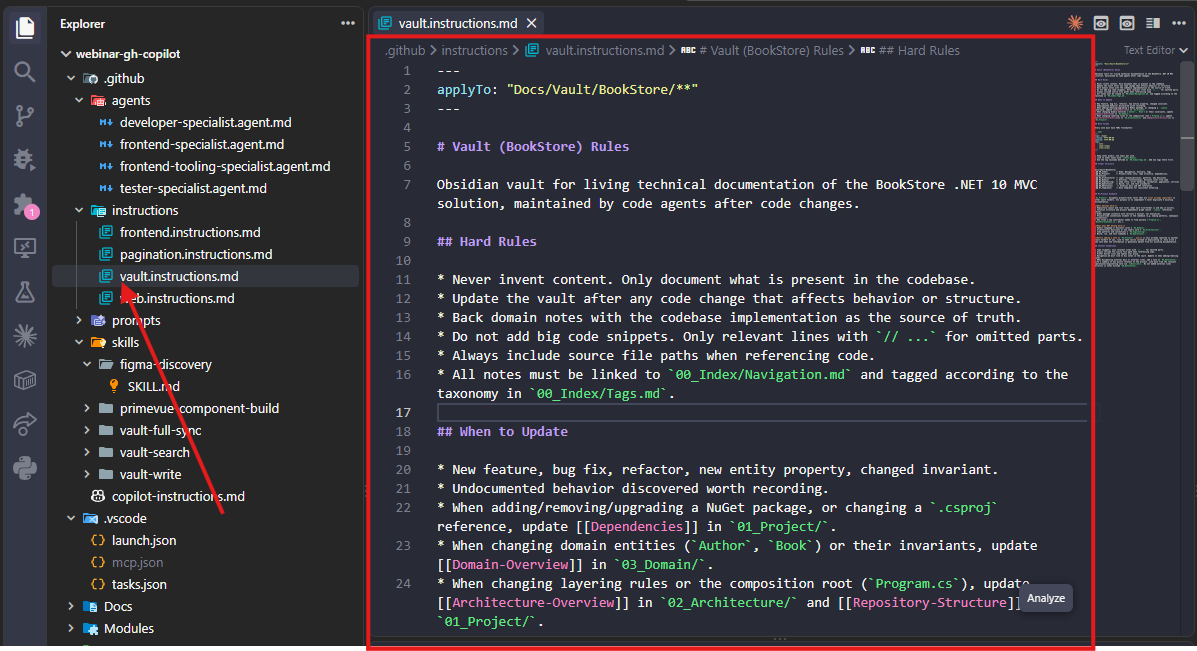
Essas quatro regras sozinhas já eliminam boa parte do risco de uma IA "alucinar" documentação. Um agente não pode escrever no vault algo que não verificou no código, e toda nota que referencia uma implementação precisa apontar o caminho real do arquivo. Isso transforma o vault numa fonte confiável para o próximo agente consultar, em vez de mais um texto solto que pode estar desatualizado.
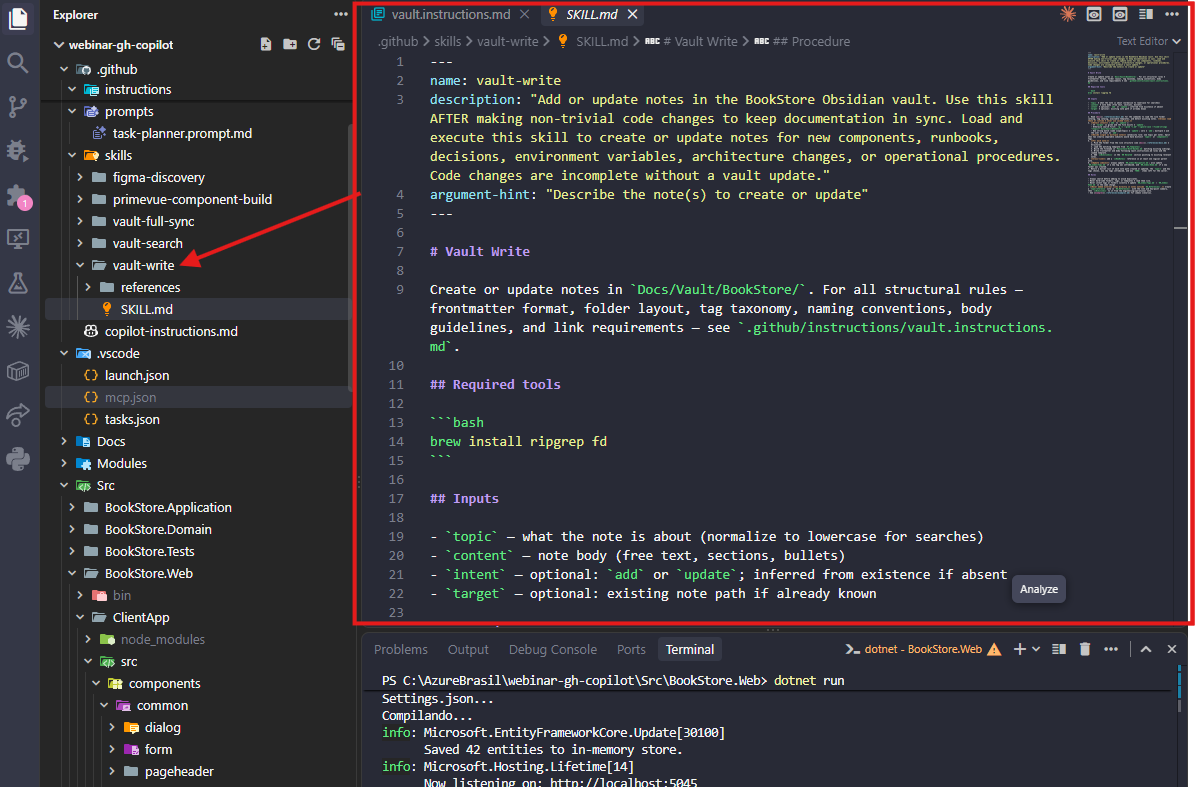
A escrita nesse vault não é feita à mão pelo agente de front-end, ela passa por uma skill própria, a /vault-write, que decide se cria uma nota nova ou atualiza uma existente:
---
name: vault-write
description: "Add or update notes in the BookStore Obsidian vault. Use this skill AFTER making non-trivial code changes to keep documentation in sync. Load and execute this skill to create or update notes for new components, runbooks, decisions, environment variables, architecture changes, or operational procedures. Code changes are incomplete without a vault update."
argument-hint: "Describe the note(s) to create or update"
---

# Vault Write

Create or update notes in `Docs/Vault/BookStore/`. For all structural rules — frontmatter format, folder layout, tag taxonomy, naming conventions, body guidelines, and link requirements — see `.github/instructions/vault.instructions.md`.

## Required tools

```bash
brew install ripgrep fd
```

## Inputs

- `topic` — what the note is about (normalize to lowercase for searches)
- `content` — note body (free text, sections, bullets)
- `intent` — optional: `add` or `update`; inferred from existence if absent
- `target` — optional: existing note path if already known

## Procedure

1. Read [docs](./references/docs.md) for the commands to load the live folder catalog, tag catalog, available templates, and detect existing notes. **Always load these at runtime — never use cached lists.**
2. **Detect intent** (`add` vs `update`):
   - If `target` is given and the file exists → `update`.
   - Otherwise search first: `rg -l --glob "*.md" --ignore-case --fixed-strings "<topic>" Docs/Vault/BookStore`.
   - One strong match (same scope/topic) → `update`; zero → `add`; multiple → ask the user or treat as `add`.
3. **Decide single vs multiple notes** (atomicity rule: one topic per note). Split when two clearly separable subjects would have distinct `type/*` or `component/*` tags.
4. **For each note:**
   1. Pick the folder from the live structure (see [docs](./references/docs.md) → Structure).
   2. Load the matching template from `07_Templates/`.
   3. Build the filename in `PascalCase-With-Dashes.md` matching existing siblings.
   4. Write frontmatter and body following vault.instructions.md rules and the loaded template.
   5. Add `[[Wikilinks]]` in the `## Related` section pointing to existing relevant notes.
5. **Cross-link**: add a `[[NewNote]]` reference in at least one logical parent note.
6. **Update indexes**: always update `00_Index/Navigation.md`; also update `00_Index/Tags.md` if a new tag was introduced, and `00_Index/Home.md` if a new folder was created.
7. Return a bullet list of each note path created or updated, the `type/*` and key tags chosen, any new tags introduced, and any `TODO:` items left for the caller.

## Rules

- Always search before adding to avoid duplicates.
- Never hard-code folders, tags, or templates — read them live.
- Never invent tags or folders silently — update `00_Index/Tags.md` / `00_Index/Home.md` in the same change.
- **Never embed external links directly in notes outside `06_References/`.** Create a `type/reference` note in `06_References/` with the link and key-point summary, then `[[Wikilink]]` to it from the engineering/operational note.
- See [examples](./references/examples.md) for common scenarios.
- Detectar intenção (add vs update): buscar o tópico com rg antes de decidir
- Decidir se o conteúdo cabe numa nota só ou precisa ser dividido (uma nota por tópico)
- Escolher a pasta certa (00_Index, 01_Project, 02_Architecture, 03_Domain, 04_Engineering, 05_Operations, 06_References)
- Escrever a nota seguindo o frontmatter e a taxonomia de tags já existente
- Atualizar Navigation.md e, se necessário, Tags.md
Detectar intenção (add vs update)
- Roda uma busca por texto simples no vault antes de decidir se cria uma nota nova ou atualiza uma já existente, evitando duplicar conteúdo.
Escolher a pasta certa
- Cada assunto tem um destino fixo, decisões de arquitetura vão para
02_Architecture, procedimentos de build vão para05_Operations, e assim por diante, o que evita que a mesma informação apareça espalhada em lugares diferentes.
Atualizar Navigation.md
- Garante que toda nota nova fique alcançável a partir do índice principal do vault, em vez de virar um arquivo órfão que ninguém mais encontra.
Do lado oposto dessa skill está a /vault-search, chamada obrigatoriamente antes de qualquer tarefa nos dois agentes de front-end, que faz busca textual no vault usando pipelines encadeados de rg (ripgrep) em vez de depender de busca semântica. Isso é uma escolha deliberada de precisão: como a regra número um do vault é nunca inventar conteúdo, a busca também não pode inventar relevância, ela precisa encontrar o termo exato ou um termo próximo o suficiente antes de recombinar.
Só que documentação em Markdown resolve a parte de "o que foi decidido e por quê". A parte de "como o comportamento é implementado de forma consistente" fica a cargo dos composables do Vue, funções que encapsulam um pedaço de lógica com estado e são reaproveitadas por várias telas. O usePagedFetch é o mais simples deles:
export function usePagedFetch<T>(apiUrl: string) {
  const items = ref<T[]>([]);
  const totalRecords = ref(0);
  const loading = ref(false);
  const error = ref<string | null>(null);

  async function load(pageNumber: number, pageSize: number) {
    loading.value = true;
    error.value = null;
    try {
      const response = await fetch(`${apiUrl}?page=${pageNumber}&pageSize=${pageSize}`);
      if (!response.ok) throw new Error(`Request failed with status ${response.status}`);
      const data: PagedResult<T> = await response.json();
      items.value = data.items;
      totalRecords.value = data.totalItems;
    } finally {
      loading.value = false;
    }
  }

  return { items, totalRecords, loading, error, load };
}usePagedFetch(apiUrl)
- Recebe a URL base do endpoint da API e devolve o estado reativo de itens, total de registros, carregamento e erro, junto de uma função
loadpara buscar uma página específica.
load(pageNumber, pageSize)
- Faz o fetch contra o endpoint paginado do ASP.NET Core, seguindo o contrato
PagedResult<T>do backend, e atualiza o estado reativo, sem que a tela precise reimplementar tratamento de erro ou de carregamento.
Esse composable é a razão pela qual nenhuma tabela do BookStore, seja de Book, Author ou Customer, implementa paginação no lado do cliente ou repete a lógica de try/catch de uma chamada fetch. Quando o Frontend-Specialist recebe a tarefa de criar uma nova tela com listagem, a própria skill primevue-component-build instrui a checar usePagedFetch antes de escrever qualquer chamada de rede nova.
O mesmo raciocínio se aplica a um estado mais complexo, o de excluir e editar uma linha de uma tabela, encapsulado no useEntityCrud:
export function useEntityCrud<TEntity extends { id: number }, TEditPayload>(
  options: UseEntityCrudOptions,
) {
  const { apiUrl, entityLabel, reload } = options;

  const deleteDialogVisible = ref(false);
  const deleteTarget = ref<TEntity | null>(null);
  const deleteLoading = ref(false);
  const deleteError = ref<string | null>(null);

  async function onDeleteConfirm() {
    if (!deleteTarget.value) return;
    deleteLoading.value = true;
    deleteError.value = null;
    try {
      const response = await fetch(`${apiUrl}/${deleteTarget.value.id}`, { method: "DELETE" });
      if (!response.ok) throw new Error(await parseErrorMessage(response));
      deleteDialogVisible.value = false;
      await reload();
    } catch (err) {
      deleteError.value = err instanceof Error ? err.message : `Failed to delete the ${entityLabel}.`;
    } finally {
      deleteLoading.value = false;
    }
}useEntityCrud(options)
- Recebe a URL base da API, um rótulo do tipo de entidade para mensagens de erro, e uma função de recarregar a página atual da tabela, e devolve o estado de diálogo de exclusão e edição prontos para uso.
onDeleteConfirm()
- Executa a chamada DELETE contra a API, trata o corpo de erro devolvido pelo backend em caso de falha (por exemplo, uma
DomainExceptionde "não é possível excluir um autor com livros"), e recarrega a tabela só quando a exclusão é bem-sucedida.
O detalhe interessante aqui é que esse composable não foi escrito de uma vez só, ele nasceu de um padrão repetido manualmente na tela de Books, depois copiado quase igual para Authors, até um agente perceber a duplicação e extrair a lógica comum. Esse tipo de refino incremental só funciona de forma segura porque o vault já tinha registrado, de uma tarefa anterior, exatamente onde ficava esse código duplicado e por quê ele existia daquele jeito.
Além da documentação e dos composables, existe uma terceira camada de memória, mais defensiva: os guardrails escritos diretamente no corpo dos arquivos .agent.md. Depois que o Bootstrap foi removido do projeto inteiro, o Frontend-Specialist carrega uma instrução fixa de auditoria, que manda rodar uma busca por bootstrap|bi-|cdn.jsdelivr.net/npm/bootstrap em todo o BookStore.Web antes de qualquer tarefa ser considerada concluída. Isso importa porque views antigas do Razor ainda usam nomes de classe como btn-primary e form-control, só que agora apoiados em classes Tailwind customizadas com o mesmo nome, não mais no Bootstrap real. Sem esse guardrail escrito explicitamente, seria fácil um agente futuro confundir esse nome de classe legado com um resquício a remover, ou pior, reintroduzir a biblioteca original ao tentar "corrigir" um estilo.
Imagem: Estrutura de pastas do vault Docs/Vault/BookStore aberta no VS Code, mostrando as pastas 00_Index até 07_Templates
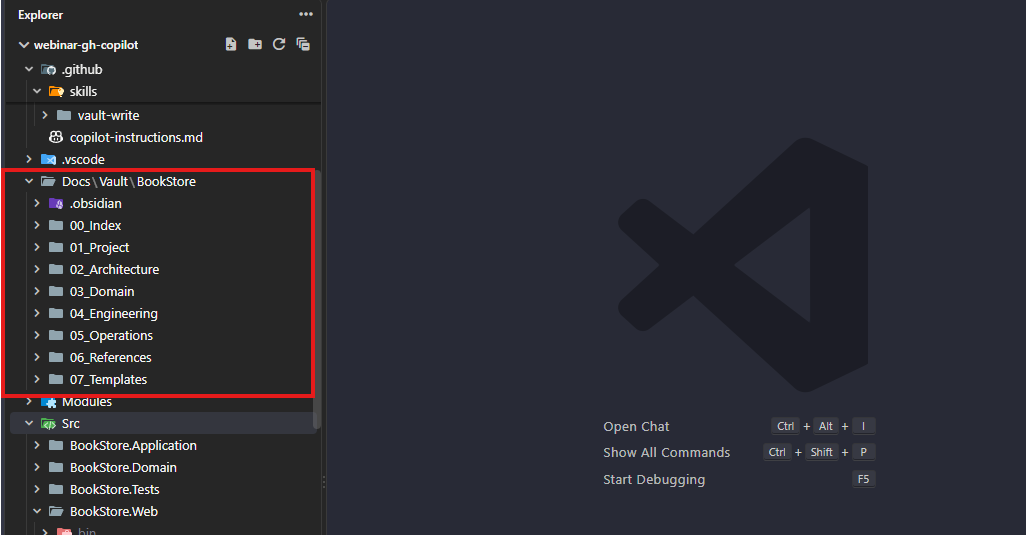
Imagem: uma nota do vault aberta no Obsidian, mostrando o frontmatter YAML com tags e um wikilink para outra nota
Juntando as três camadas, o vault registra o porquê de uma decisão, os composables garantem que o como seja sempre o mesmo código reaproveitado, e os guardrails nos arquivos de agente impedem que uma regressão já corrigida volte a acontecer. Nenhuma dessas camadas sozinha resolveria o problema de memória entre sessões, mas juntas elas permitem que um agente do GitHub Copilot, meses depois e numa conversa totalmente nova, continue exatamente de onde a tela de Customers parou, sem perder nem o contexto de design nem as decisões técnicas já tomadas.
Essa foi a última parte dessa trilogia sobre a modernização do front-end do BookStore, cobrindo a jornada completa, da introdução do PrimeVue e do Tailwind CSS até a extração de dois Custom Agents, passando pelo uso do Figma MCP e chegando agora na camada de memória que sustenta tudo isso ao longo do tempo.
O código completo deste projeto está disponível no meu repositório no GitHub.
Links e Docs:


Não esqueça de me seguir no LinkedIn para mais conteúdos.
Até a próxima!!!