O que o Linux faz com o pacote antes da sua aplicação saber que ele existe
Nove passos dentro do kernel, da placa de rede até o TCP: sk_buff, validação do IP, netfilter, conntrack, NAT, decisão de rota e firewall. Seguindo um SYN para a porta 8080.
A requisição não aparece no log da API. O cliente jura que mandou. Você olha o APM, olha o log do Nginx, olha o log do container, e nada. Para a sua aplicação, aquele pacote nunca existiu.
E ela tem razão. Ele não existiu para ela.
Antes de qualquer accept(), antes de qualquer middleware, antes do primeiro byte chegar no seu código, o kernel do Linux já fez nove coisas com aquele pacote. Validou, carimbou, consultou tabelas, decidiu se o pacote era para esta máquina e passou por um firewall. Em qualquer um desses passos o pacote pode ser descartado em silêncio, e a sua aplicação nunca vai ficar sabendo.
Por muito tempo eu tratei essa parte como um cano: entra pacote de um lado, sai requisição do outro. Funciona, até o dia em que não funciona. E nesse dia o problema está exatamente no pedaço que ninguém olha.
Este post é o primeiro de uma série que sobe da placa de rede até a aplicação, um trecho por vez. Aqui o trecho é do kernel até o TCP.
O pacote que vamos seguir
Vamos acompanhar um pacote só: o primeiro de uma conexão nova. Um SYN saindo de um cliente qualquer para a porta 8080 deste servidor.
SYN · 203.0.113.7:51544 → 10.0.0.5:8080 · proto 6
Origem 203.0.113.7, porta efêmera 51544. Destino 10.0.0.5, porta 8080. Protocolo 6, que é TCP. Guarda essa linha, porque cada passo vai ler um pedaço dela.
Escolhi o primeiro pacote de propósito. Ele é o que dá mais trabalho para o kernel: ninguém conhece essa conexão ainda, então todas as tabelas são consultadas de verdade. Os pacotes seguintes pegam atalhos, e você vai ver onde.
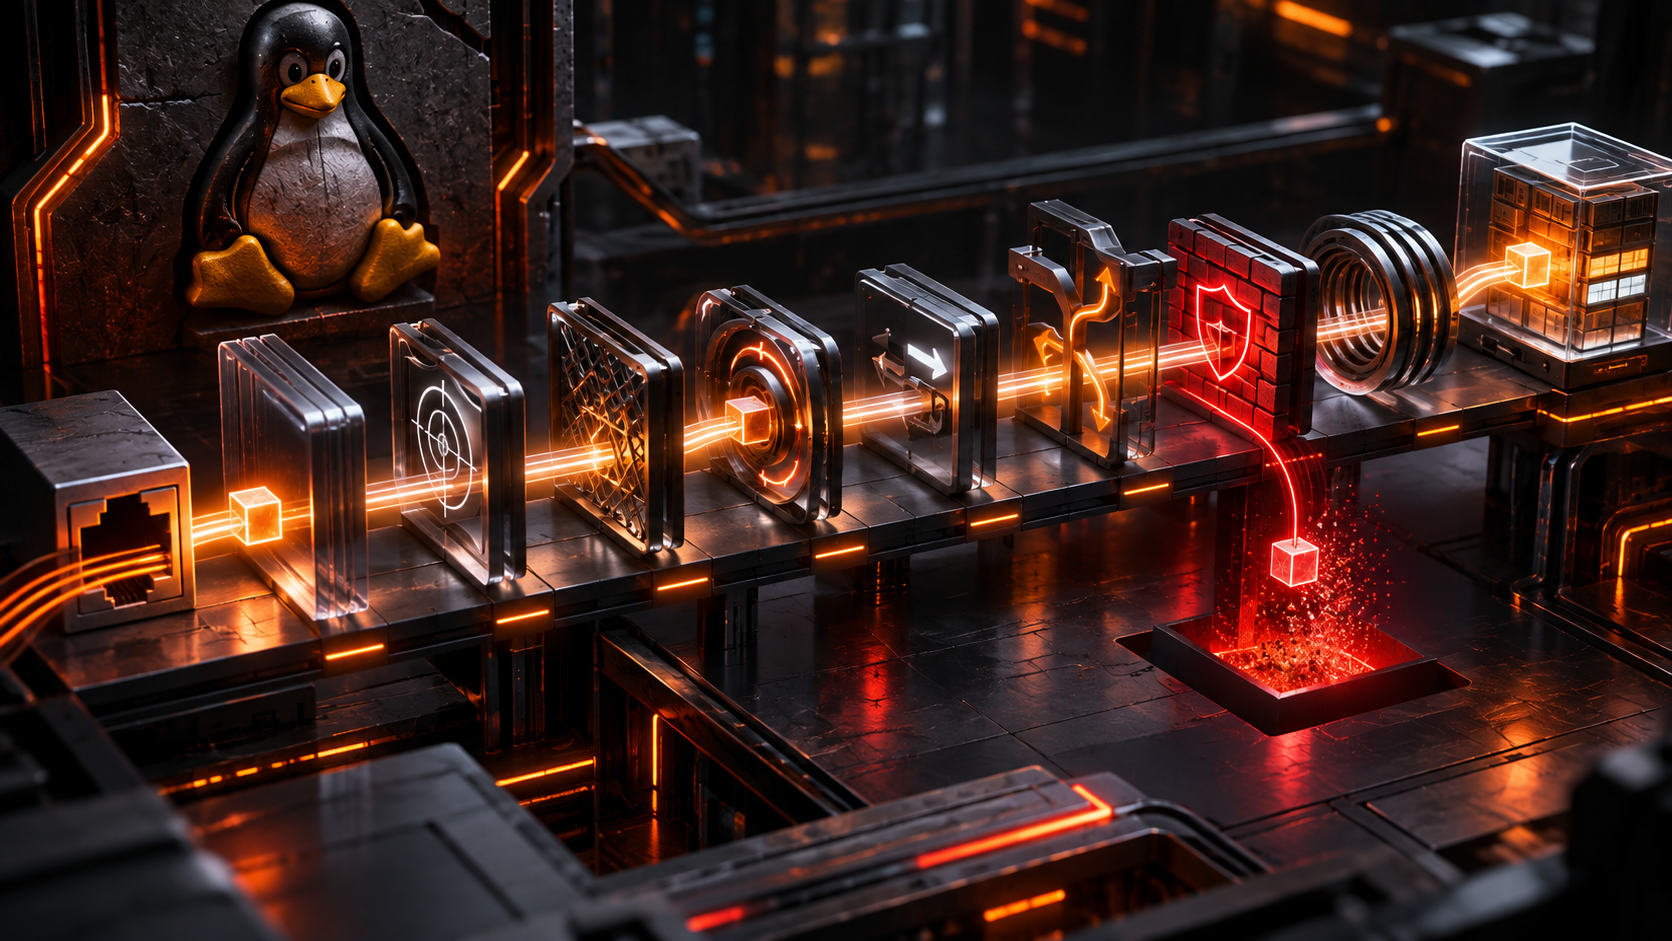
O mapa é esse aí. Os passos em azul são o código de rede do kernel. Os roxos são os ganchos do netfilter. O âmbar no fim é o TCP. As caixas penduradas embaixo de cada passo são os desvios: cinza quando o pacote vai para outro caminho, vermelho quando ele é descartado.
Vamos lá.
1. Chegou no kernel: o sk_buff
A placa de rede recebe o quadro, copia para a memória via DMA e avisa o kernel. A partir daí, o pacote vive dentro de uma estrutura chamada struct sk_buff (todo mundo chama de skb).
O ponto importante sobre o sk_buff é que ele é a mesma estrutura do começo ao fim. O kernel não copia o pacote de camada em camada. Cada camada só ajusta ponteiros: este é o começo do cabeçalho Ethernet, este é o começo do IP, este é o começo do TCP. Quando uma camada termina, ela avança o ponteiro e passa o mesmo sk_buff adiante.
Na prática, é por isso que o Linux consegue empurrar milhões de pacotes por segundo numa máquina comum. Copiar dado é caro. Mexer em ponteiro é barato.
2. Que protocolo é esse?
Primeira decisão. O cabeçalho Ethernet tem um campo de 2 bytes chamado EtherType, e é ele que diz para quem o kernel entrega o resto.
| EtherType | Protocolo | Quem recebe |
|---|---|---|
0x0800 |
IPv4 | ip_rcv() |
0x86DD |
IPv6 | ipv6_rcv() |
0x0806 |
ARP | arp_rcv() |
O nosso pacote diz 0x0800. Vai para ip_rcv(), o código do IPv4. Se fosse IPv6 ou ARP, seguiria por outro caminho, com outras regras, e este post seria outro.
3. O cabeçalho IP é válido?
Dentro de ip_rcv(), o kernel confere o cabeçalho IP antes de confiar em qualquer campo dele: versão 4, tamanho mínimo de 20 bytes, comprimento total coerente com o que chegou e checksum batendo.
Se alguma coisa não bate, o pacote é descartado. Sem resposta, sem ICMP, sem log. Ninguém avisa o remetente.
O único rastro é um contador. Se você suspeita de pacote corrompido chegando (placa com problema, cabo ruim, offload maluco), é aqui que você olha:
# Contadores de erro de cabeçalho IP e de checksum
nstat -az IpInHdrErrors IpExtInCsumErrors

# ou direto na fonte
grep '^Ip:' /proc/net/snmp
Se o IpInHdrErrors está subindo, a sua aplicação não tem nada a ver com isso. O problema está antes dela.
4. Entra o netfilter: o gancho PREROUTING
Aqui está o ponto que mais confunde. Muita gente fala do netfilter como se fosse "o firewall" ou "um passo" do caminho. Ele não é um passo. É um conjunto de ganchos espalhados pelo caminho.
Em cada gancho, o kernel para e executa tudo que estiver registrado ali: regras de firewall, rastreamento de conexão, NAT, marcação de pacote. O iptables, o nftables, o conntrack, o kube-proxy e o Docker são todos clientes desses ganchos. Nenhum deles é o gancho.
No caminho de entrada, os ganchos que importam para o nosso pacote são dois:
- PREROUTING: antes da decisão de rota. É onde o pacote chega primeiro.
- INPUT: depois da decisão de rota, só para pacotes destinados a esta máquina.
Dentro do PREROUTING, as coisas rodam numa ordem fixa, definida por prioridade no kernel:
PREROUTING: raw (-300) → conntrack (-200) → mangle (-150) → nat/DNAT (-100)
Essa ordem não é detalhe. Ela explica por que o conntrack já sabe da conexão quando o NAT roda, e por que a tabela raw é o lugar para dizer "não rastreia isso aqui" (NOTRACK). Os próximos dois passos acontecem dentro desse gancho.
5. conntrack: eu conheço essa conexão?
O conntrack (connection tracking) procura o pacote numa tabela, usando a tupla de origem e destino: IP de origem, porta de origem, IP de destino, porta de destino e protocolo.
Como este é o primeiro pacote, ninguém conhece. O kernel marca a conexão como NEW e cria uma entrada. Os próximos pacotes dessa mesma conexão vão ser encontrados ali e marcados como ESTABLISHED.
Um detalhe que pouca gente sabe: essa entrada nova só é confirmada na tabela quando o pacote termina o caminho (no fim do INPUT, no nosso caso). Se o firewall descartar o pacote no passo 8, a entrada some junto. Faz sentido: não tem por que guardar uma conexão que o próprio servidor recusou.
Você consegue ver a tabela ao vivo:
# Quantas entradas existem e qual é o limite
sysctl net.netfilter.nf_conntrack_count net.netfilter.nf_conntrack_max

# As entradas da porta 8080 (precisa do pacote conntrack-tools)
conntrack -L -p tcp --dport 8080
Guarda o nf_conntrack_max. Essa tabela tem tamanho. Quando ela enche, o pacote novo é descartado antes de chegar em qualquer lugar, e o único aviso é uma linha no dmesg. Esse é o assunto do próximo post da série.
6. NAT de destino: troca o destino? Só no primeiro pacote
Ainda dentro do PREROUTING, a tabela nat pode trocar o destino do pacote. Isso se chama DNAT, e você usa todo dia sem perceber.
É assim que o Docker faz o -p 8080:80 funcionar: uma regra na cadeia DOCKER troca host:8080 por IP-do-container:80. É assim que o kube-proxy (no modo iptables) faz um Service funcionar: o IP virtual do Service, tipo 10.96.0.20:80, é trocado pelo IP de um pod de verdade, tipo 10.244.1.7:8080.
# As regras de DNAT do Docker
iptables -t nat -L DOCKER -n --line-numbers

# A porta de entrada das regras do kube-proxy
iptables -t nat -L KUBE-SERVICES -n | head -20
Agora o detalhe que muda a forma como você pensa sobre NAT: a tabela nat só é lida no primeiro pacote da conexão. O resultado da tradução fica guardado na entrada do conntrack, e os pacotes seguintes recebem a mesma troca direto, sem passar pelas regras de novo.
O que significa que, se você mudar uma regra de DNAT, as conexões que já existem continuam indo para o destino antigo até fecharem. Já vi gente jurar que a regra "não pegou" quando, na verdade, ela pegou perfeitamente para toda conexão nova. Depende do contexto, mas um conntrack -D na conexão certa resolve a dúvida em segundos.
No nosso pacote, nenhuma regra de DNAT bate. O destino continua 10.0.0.5:8080.
7. Decisão de rota: é pra mim?
Com o destino definido, o kernel decide para onde o pacote vai. A primeira tabela consultada é a local, que lista os IPs que pertencem a esta máquina.
# A ordem das tabelas: local primeiro, depois main
ip rule show
# 0:      from all lookup local
# 32766:  from all lookup main
# 32767:  from all lookup default

# Os IPs desta máquina
ip route show table local
10.0.0.5 está lá. O pacote é para cá e segue para o gancho INPUT.
Se não estivesse, sobram duas saídas. Se a máquina está configurada como roteador (net.ipv4.ip_forward=1), o pacote vai para o gancho FORWARD e segue viagem. Se não está, é descartado.
E agora a ordem dos passos 6 e 7 faz sentido: o NAT vem antes da rota justamente para que a rota seja decidida com o destino já trocado. É por isso que um pacote para o IP de um Service do Kubernetes, que não pertence a máquina nenhuma, chega no pod. Quando a rota é decidida, o destino já é o IP do pod. Num nó do Kubernetes, ip_forward está ligado exatamente por causa disso.
8. Gancho INPUT: aqui fica o firewall
O pacote é local, então passa pelo segundo gancho do netfilter, o INPUT. É aqui que mora o firewall de entrada da máquina, a tabela filter.
As regras são lidas em ordem, de cima para baixo, e a primeira que bate com um alvo final decide. No nosso exemplo, a regra 1 aceita conexões já estabelecidas (não é o caso, a nossa é NEW). A regra 2 aceita TCP na porta 8080. Bate. ACCEPT.
iptables -L INPUT -n -v --line-numbers
# 1  ACCEPT  all  --  0.0.0.0/0  0.0.0.0/0  ctstate RELATED,ESTABLISHED
# 2  ACCEPT  tcp  --  0.0.0.0/0  0.0.0.0/0  tcp dpt:8080
(Se a sua distro usa nftables, o comando é nft list ruleset. O gancho é o mesmo; muda a ferramenta que escreve nele.)
O que acontece quando a regra que bate não é ACCEPT é o que mais importa para quem debuga, porque os dois jeitos de recusar parecem coisas completamente diferentes do lado do cliente:
| Alvo | O que o servidor faz | O que o cliente vê |
|---|---|---|
ACCEPT |
Deixa passar | A conexão segue normalmente |
DROP |
Descarta sem responder | O cliente reenvia o SYN várias vezes até dar timeout. No Linux, com o padrão tcp_syn_retries=6, isso leva uns dois minutos. Parece servidor fora do ar |
REJECT |
Descarta e avisa (ICMP port unreachable por padrão, ou TCP RST com --reject-with tcp-reset) |
connection refused na hora |
Lembra do pacote que nunca chegou no log da API? Se o cliente recebe timeout, um dos suspeitos é um DROP no INPUT. Se recebe connection refused com o serviço de pé, o suspeito é um REJECT. Saber essa diferença economiza horas de olhar log de aplicação que nunca vai mostrar nada.
E se nenhuma regra bate? Vale a política padrão da cadeia, aquele policy ACCEPT ou policy DROP que aparece no cabeçalho do iptables -L. Cuidado com ela: muita gente escreve regras de ACCEPT com a política em DROP e esquece de liberar alguma coisa.
9. Entrega ao TCP
Último passo dentro da camada IP. O kernel lê o campo de protocolo do cabeçalho IP para saber quem recebe o pacote.
| Protocolo | Quem recebe |
|---|---|
6 |
TCP → tcp_v4_rcv() |
17 |
UDP → udp_rcv() |
1 |
ICMP → icmp_rcv() |
O nosso diz 6. O kernel avança o ponteiro do sk_buff para depois do cabeçalho IP (lembra do passo 1? sem copiar nada) e entrega o pacote para o código do TCP.
É aqui que este trecho da série termina. A sua aplicação ainda não sabe que esse pacote existe. Para ela saber, o TCP ainda vai precisar fazer o handshake, colocar a conexão numa fila e esperar alguém chamar accept(). Isso vem nos próximos posts.
Então, o que o Linux faz antes da aplicação?
Recapitulando, na ordem em que o kernel executa:
- Guarda o pacote num
sk_buff, que vai ser o mesmo até o fim. - Lê o EtherType e manda para o código do IPv4.
- Valida o cabeçalho IP e descarta em silêncio o que não bate.
- Entra no gancho PREROUTING do netfilter.
- O conntrack procura a conexão e cria uma entrada NEW.
- A tabela
natpode trocar o destino, e isso fica guardado no conntrack. - Decide a rota com o destino já trocado.
- Passa pelo firewall no gancho INPUT.
- Entrega ao TCP.
Em pelo menos quatro desses passos o pacote pode morrer sem a sua aplicação ficar sabendo: cabeçalho inválido, destino que não é desta máquina, regra de DROP ou REJECT, e a tabela do conntrack cheia. Nenhum deles aparece no log da aplicação. Todos aparecem em algum contador ou tabela do kernel, se você souber onde olhar.
Na prática, a lição é simples: quando a requisição "não chegou", pare de olhar só para a aplicação. Desce um andar. Os comandos deste post são um bom começo.
No próximo post, a tabela do conntrack: ela tem tamanho, e quando enche, o pacote novo some antes de chegar aqui.
Comportamento e valores padrão do Linux 6.x. Podem variar conforme a distribuição e a versão do kernel.
E aí, gostou? Se o seu tráfego some no caminho entre o load balancer e a aplicação, ou se o seu cluster Kubernetes está descartando conexão sem explicar por quê, a gente na AzureBrasil.cloud pode te ajudar.